He estado probando a construir un RAG multimodal sobre imágenes.
La parte que más me interesaba no era solo analizar la imagen, sino convertir esa salida en contexto recuperable para un LLM.
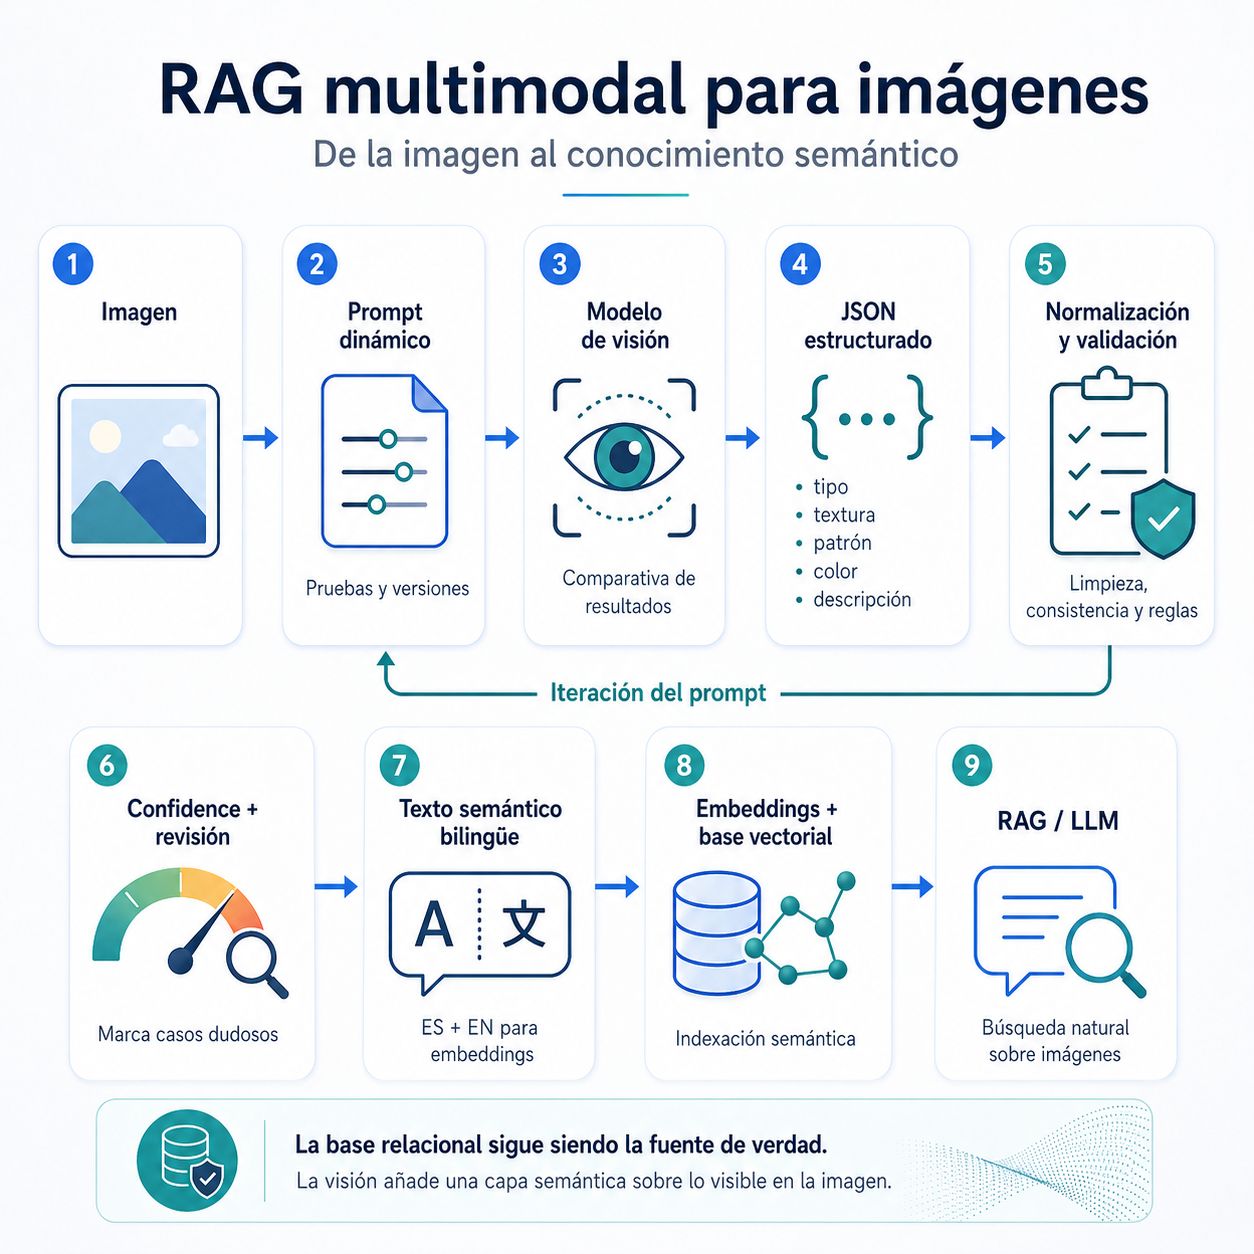
La parte de visión no es nueva, evidentemente. Analizar imágenes, extraer atributos o clasificar contenido lleva muchos años haciéndose. Lo que me interesaba probar era otra cosa: cómo usar esa información visual para enriquecer un sistema RAG y dar mejor contexto a un modelo.
La prueba ha ido por ahí: coger una imagen, analizarla con un modelo de visión en local, convertir esa salida en algo estructurado y después prepararla para que pueda formar parte de un índice vectorial. Al final, lo que busco no es que el modelo describa una imagen sin más, sino que esa descripción se convierta en contexto recuperable.
He estado probando varios modelos locales con Ollama y, manteniendo el mismo prompt y las mismas imágenes, Gemma 4 e4b me ha dado resultados bastante buenos, la verdad, bastante mejor que Qwen2.5 VL.
No tanto por hacer algo espectacular, sino por algo mucho más práctico: devuelve un JSON bastante limpio, mantiene bien la estructura y genera descripciones suficientemente consistentes como para poder seguir trabajando sobre ellas.
Donde más tiempo se va es ajustando el prompt, probando variaciones, limpiando respuestas, normalizando campos, evitando que el modelo se venga arriba con cosas que no debería afirmar y decidiendo cuándo una salida es fiable o cuándo conviene marcarla para revisión. Esa parte es menos vistosa, pero es la que hace que el experimento empiece a parecer algo usable.
Me gusta especialmente la separación de responsabilidades. La base de datos sigue siendo la fuente para el dato estructurado. La visión añade una capa semántica sobre lo que se aprecia en la imagen. Los embeddings permiten recuperar esa información de forma más flexible. Y el LLM recibe mejor contexto para responder.
Ahí es donde creo que está el valor: no en sustituir el dato existente, sino en complementarlo.
Con este enfoque se pueden plantear búsquedas más naturales sobre colecciones de imágenes, no solo por nombres, códigos o etiquetas manuales, sino también por características visuales, tono, textura, patrón, acabado o similitud semántica.
Siguiente paso: probarlo con más muestras, medir la calidad de la recuperación y combinar esta capa textual con búsqueda visual real.