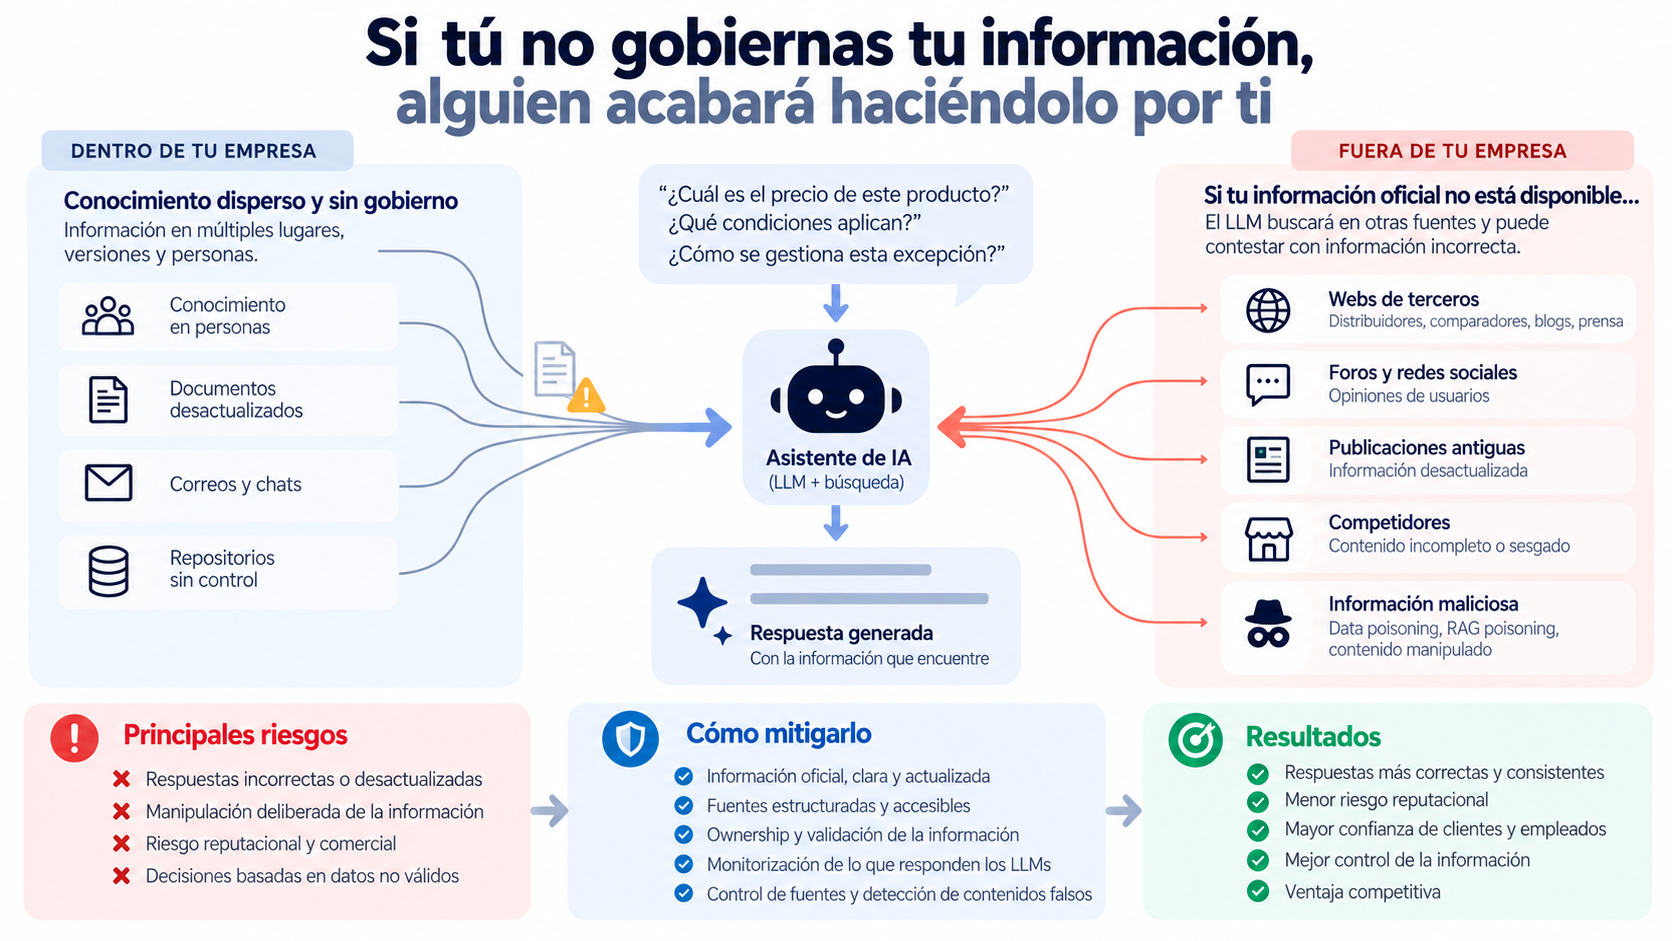
Trabajar con inteligencia artificial en la empresa me está haciendo cambiar de opinión sobre la importancia del modelo frente al contexto. Durante bastante tiempo, cuando una respuesta no era buena, asumía que necesitábamos un modelo mayor, con más capacidad de razonamiento o incluso de otro proveedor. El modelo importa, pero muchas veces intentamos resolver con tamaño un problema de información, arquitectura y conocimiento de la organización.
La elección también tiene una consecuencia económica. Los modelos grandes suelen implicar más coste de inferencia, latencia e infraestructura. Si además los acompañamos de prompts enormes, muchas herramientas y abundante contexto, el gasto crece. Ante miles o millones de consultas, la pregunta ya no es cuánto cuesta una llamada, sino cuánto cuesta resolver el proceso completo.
Podemos utilizar uno de los modelos más avanzados y preguntarle por una característica de producto, una condición comercial o una decisión tomada meses atrás. Si la información está desactualizada, mal estructurada o no llega en el momento adecuado, la respuesta tendrá un límite evidente. Solemos atribuir ese fallo al modelo, aunque el problema esté en todo lo que ocurre antes. Una IA no conoce nuestra empresa por ser potente: el conocimiento continúa repartido entre sistemas, documentos y personas.
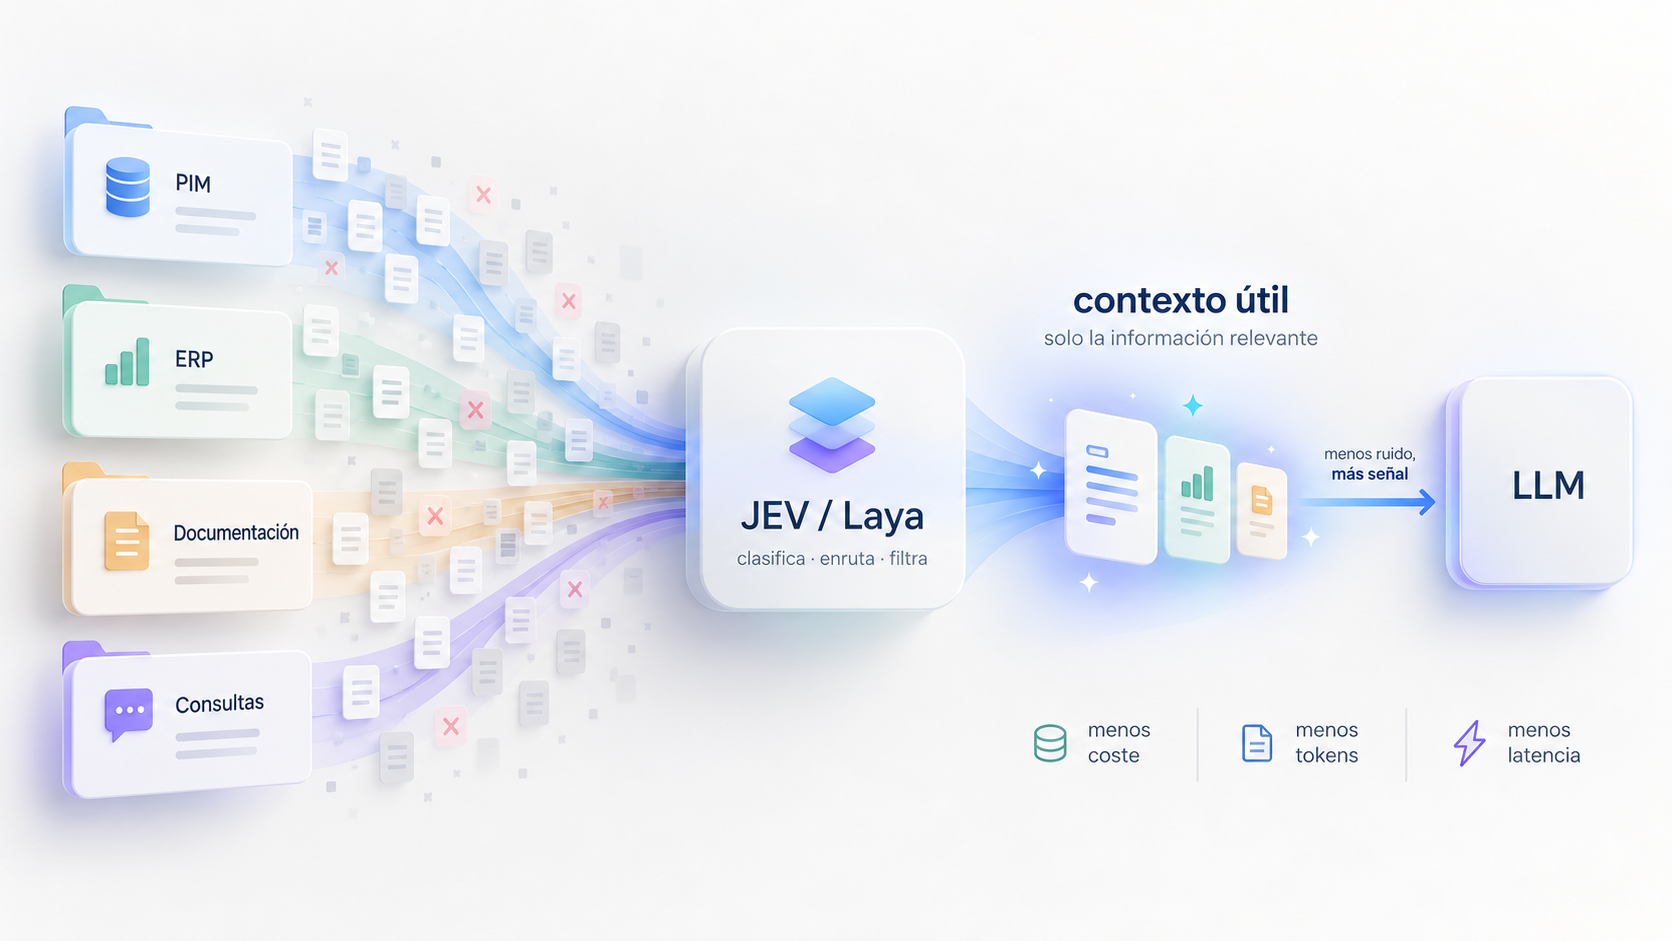
Por eso PIM, ERP, CRM, bases de datos, documentación, APIs o SharePoint pueden importar más que el modelo. No se trata de introducirlo todo en una ventana enorme, sino de identificar qué necesita cada petición y entregárselo de forma fiable. Si una respuesta requiere cinco datos, enviar cincuenta páginas puede aumentar coste, latencia y ruido sin mejorarla.
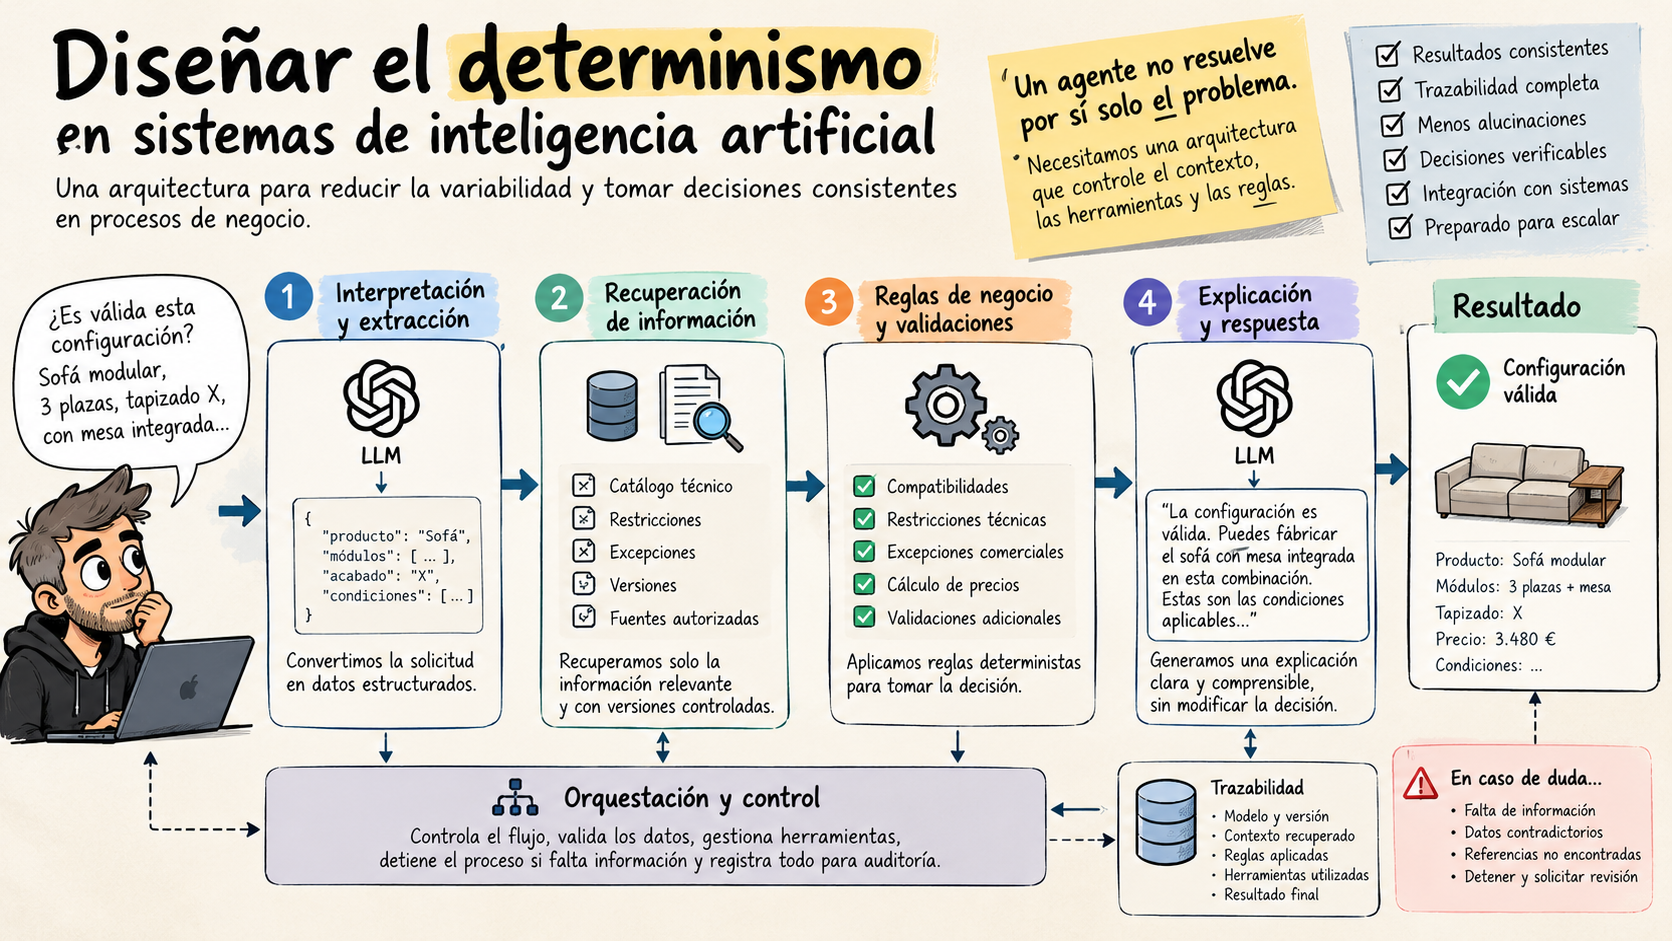
Esto me lleva a pensar menos en modelos aislados y más en sistemas completos. Antes de responder, una capa puede identificar la petición, la información necesaria, las herramientas pertinentes y el modelo adecuado. Algunas consultas justificarán un generativo potente; otras solo requerirán clasificar una entrada, consultar una fuente estructurada o aplicar una regla. No todas deberían asumir el mismo coste.
Aquí encajan modelos pequeños y especializados como JEV o Laya, que estamos explorando. Su función no tiene por qué ser redactar la respuesta final. Pueden actuar como calificadores: detectar la intención y el dominio, seleccionar una herramienta, decidir qué información recuperar o determinar si conviene escalar la petición. En lugar de pedirles una respuesta abierta, les pedimos una decisión dentro de un conjunto controlado de posibilidades.
También pueden equivocarse, pero sus errores son más fáciles de acotar y medir. Si deben elegir entre producto, precio, documentación, consulta especial o soporte, podemos evaluar su precisión, analizar falsos positivos y fijar umbrales de confianza para escalar los casos dudosos. No eliminamos el error; convertimos un problema abierto en otro más limitado y observable.
Esta primera capa reduce el contexto que recibe el modelo generativo. En vez de darle todas las instrucciones, herramientas y fuentes por si acaso, podemos construir un entorno para cada petición. Una consulta podría recibir un prompt breve, una sola herramienta y los datos imprescindibles; otra tendría una configuración diferente. El modelo puede ser el mismo, pero el problema queda mejor acotado.
La ventaja no se limita a los tokens. Cuantas más herramientas, reglas y posibilidades presentamos, más decisiones intermedias debe acertar el modelo. Puede seleccionar una herramienta incorrecta, mezclar dominios o atender una instrucción irrelevante. Reducir el espacio de decisión elimina muchas oportunidades de error y puede mejorar la respuesta al mismo tiempo que reduce coste y latencia.
El objetivo, por tanto, no debería ser conseguir la mayor ventana de contexto, sino la más pequeña que contenga todo lo necesario. Una petición puede pasar primero por un modelo pequeño, recuperar después la información adecuada y llegar a una herramienta, un servicio o un modelo mayor solo si lo necesita. En muchos casos, el modelo grande ni siquiera tendría que intervenir.
Separar decisión y generación me parece fundamental. Buena parte del trabajo de un agente empresarial consiste en decidir qué hacer a continuación: clasificar, enrutar, validar una condición o elegir una herramienta. Un modelo pequeño puede bastar para esas tareas y ofrecer ventajas de latencia, coste, privacidad y ejecución local.
Tampoco hay razón para que toda la IA de una empresa pase por un único modelo. Uno puede clasificar, otro utilizar herramientas, otro trabajar con documentos y otro generar lenguaje. El modelo deja así de ser la aplicación y se convierte en una pieza de un sistema donde contexto, permisos, observabilidad y datos importan tanto como su capacidad.
Este enfoque nos conduce a un asunto menos novedoso, pero quizá más importante: el gobierno de la información. ¿Cuál es la fuente de verdad: el ERP, el PIM, un Excel o SharePoint? ¿Quién mantiene cada dato? ¿Qué hacemos cuando dos sistemas discrepan? La automatización obliga a explicitar lo que antes resolvía una persona por experiencia. Para responder con fiabilidad debemos conocer el origen de la información, su responsable y su vigencia.
La evaluación económica debería centrarse en el proceso, no solo en el precio por token. Podemos medir cuánto tiempo ahorra una consulta, cuántos errores evita, cuántas peticiones resuelve un modelo pequeño, cuántas escalan y cuánto cuesta cada ruta. El retorno aparece cuando mejoramos el proceso completo.
Usar siempre el modelo más grande, con prompts extensos y todo el catálogo de herramientas en cada llamada, puede funcionar, pero difícilmente será eficiente al crecer el volumen. Optimizar no consiste únicamente en pagar menos por token, sino en no consumir contexto y capacidad donde no aportan valor.
En empresa, la diferencia probablemente no estará en quién accede al modelo más potente, sino en cómo diseña lo que lo rodea. Muchas veces no necesitamos una IA mucho más inteligente, sino una arquitectura que le proporcione mejor información, descarte lo irrelevante y utilice el modelo correcto en el momento adecuado. Si además lo hace con menos tokens, latencia y coste, será una solución mejor y mucho más fácil de justificar desde negocio.