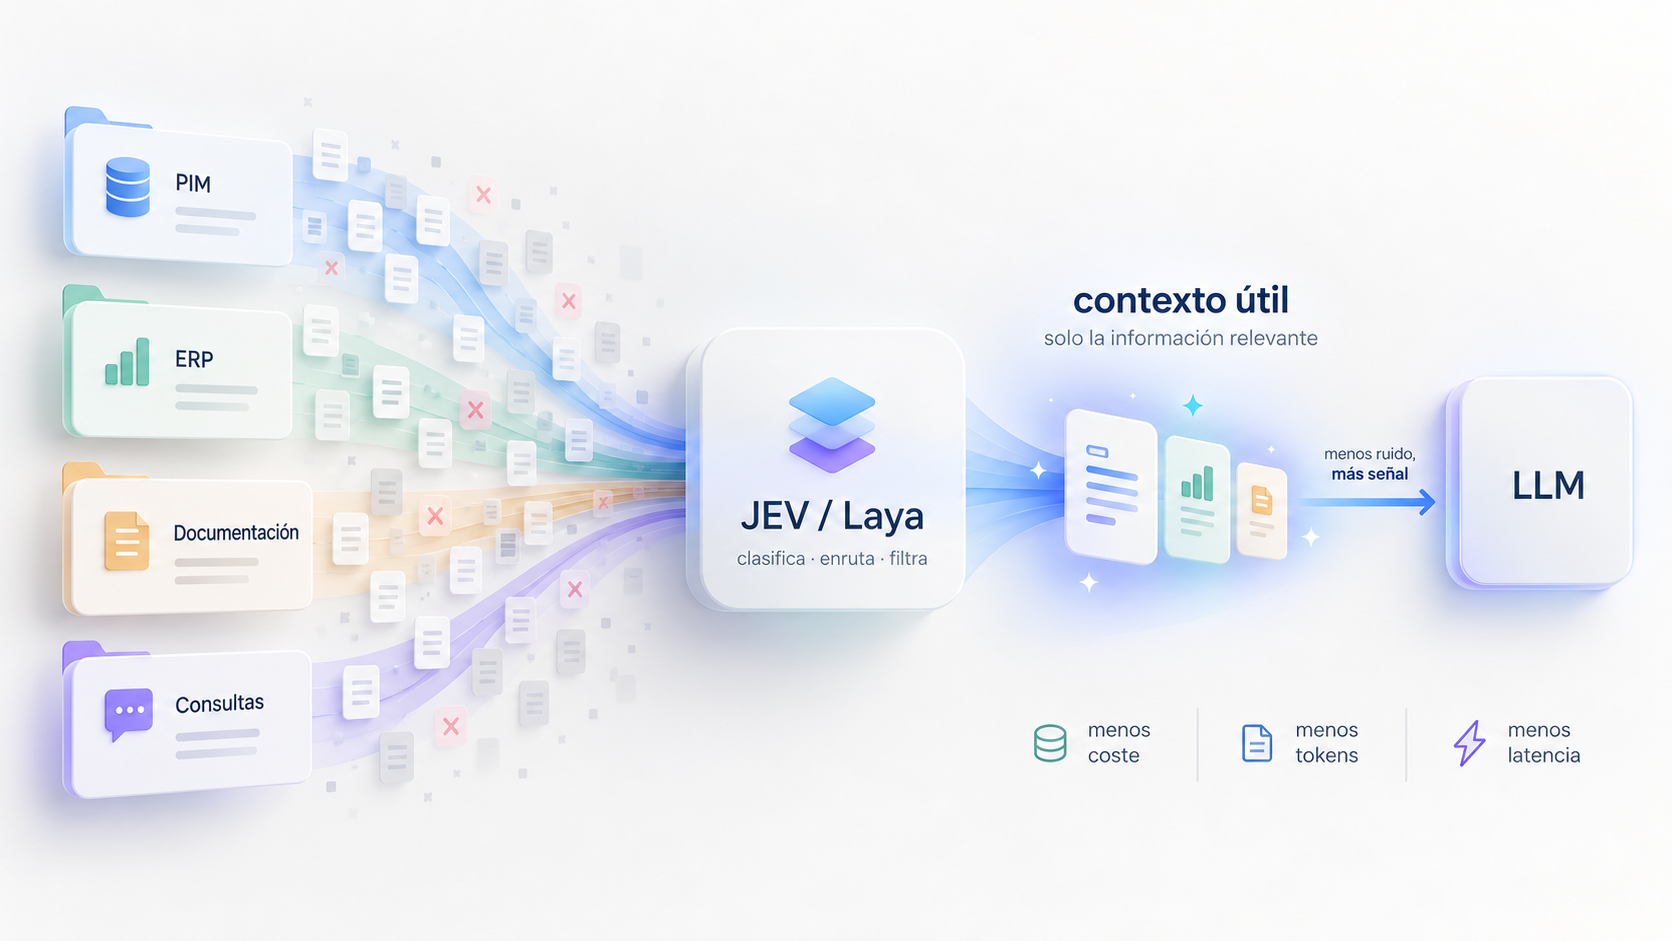
No podemos eliminar por completo la naturaleza probabilística de los LLM, pero sí diseñar sistemas que hagan sus decisiones de negocio suficientemente predecibles, trazables y fiables.
Los modelos de lenguaje (LLM) funcionan de manera probabilística, por lo que una misma entrada no tiene por qué producir siempre la misma respuesta. En determinados escenarios esta variabilidad resulta útil, especialmente cuando buscamos generar contenido o interpretar información, pero cuando empezamos a incorporar estos modelos a procesos empresariales nos encontramos con situaciones en las que necesitamos un comportamiento mucho más predecible.
Pensemos en una aplicación que analiza consultas técnicas y determina si una configuración de producto es viable. Podemos realizar diez veces la misma consulta y obtener nueve respuestas afirmativas, mientras que en la décima el modelo interpreta una restricción de manera diferente. Si esa decisión afecta a un presupuesto, una fabricación o un compromiso con un cliente, tenemos un problema que no podemos resolver simplemente aceptando que los modelos funcionan así. Necesitamos encontrar la manera de reducir esa variabilidad hasta un margen que resulte asumible para el proceso.
Una de las primeras medidas suele ser ajustar la temperatura del modelo a cero, intentando reducir la aleatoriedad durante la generación. Esto puede ayudar, aunque no garantiza resultados idénticos, ya que también intervienen factores relacionados con la infraestructura de inferencia, la precisión numérica o las versiones del modelo. Sin embargo, hay otro elemento sobre el que tenemos bastante más capacidad de actuación y al que creo que merece la pena prestar especial atención: el contexto que proporcionamos al LLM.
Cuando trabajamos con arquitecturas RAG, una misma consulta puede recuperar documentos diferentes dependiendo de cómo se realice la búsqueda, de las versiones disponibles o incluso del orden en que se incorporan los fragmentos. Si estamos evaluando la compatibilidad entre dos componentes y en una ejecución recuperamos sus especificaciones técnicas, mientras que en otra aparece también una excepción comercial, el modelo ya no está trabajando exactamente con la misma información. Por eso, antes de empezar a modificar prompts o cambiar de modelo, conviene revisar si realmente estamos manteniendo estable el contexto y si las fuentes utilizadas son las adecuadas.
Tampoco parece razonable solucionar lo anterior proporcionando toda la documentación disponible. Incorporar información redundante, condiciones que no corresponden al caso o documentos contradictorios puede introducir nuevas ambigüedades. En una validación técnica, por ejemplo, probablemente resulte más útil recuperar las características concretas de los componentes, sus restricciones y las excepciones aplicables que cargar una colección completa de fichas técnicas. Para conseguirlo necesitamos controlar las fuentes autorizadas, las versiones de la información y los criterios de recuperación, procurando que el modelo disponga de lo necesario sin añadir elementos que puedan alterar su interpretación.
Un agente no siempre es la solución
Actualmente, plataformas como Claude u OpenAI facilitan enormemente la creación de agentes capaces de consultar información, utilizar herramientas y automatizar procesos. Son soluciones que permiten avanzar muy rápido y que para muchos escenarios pueden resultar perfectamente válidas, pero cuando necesitamos decisiones consistentes, trazabilidad y garantías sobre el resultado, utilizarlas directamente puede no ser suficiente. Un agente puede interpretar una solicitud, recuperar documentación y ejecutar acciones, pero también puede variar la secuencia de pasos, seleccionar herramientas diferentes o aplicar criterios distintos entre ejecuciones. Que consiga completar una tarea no significa necesariamente que tengamos controlado cómo ha llegado a ese resultado.
En determinados procesos puede ser preferible construir una capa de orquestación que controle qué información se utiliza, qué operaciones deben ejecutarse y qué validaciones son obligatorias. No se trata de renunciar a los agentes ni de desarrollar desde cero capacidades que ya ofrecen estas plataformas, sino de decidir qué responsabilidades podemos delegar y cuáles necesitamos mantener bajo nuestro control.
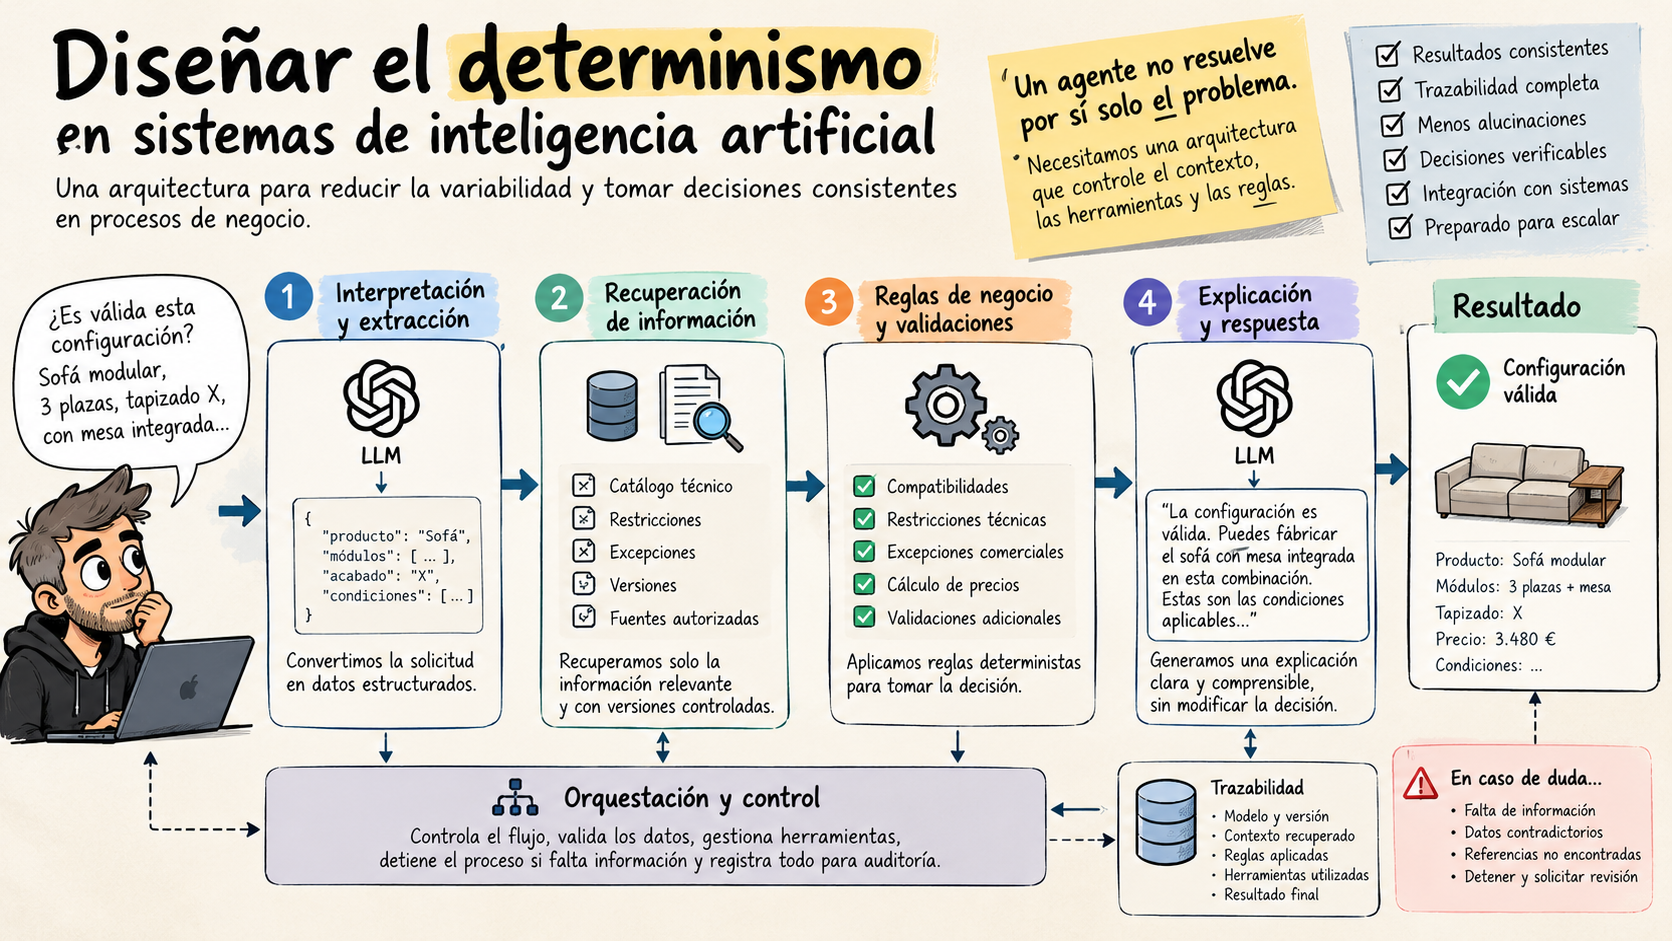
Imaginemos, por ejemplo, un sistema que recibe consultas comerciales sobre configuraciones de productos. Podemos utilizar un LLM para interpretar la solicitud e identificar referencias, dimensiones, acabados y condiciones especiales, transformando esa información en datos estructurados que después validamos. A partir de ahí, un servicio recupera las especificaciones y restricciones desde fuentes autorizadas y versionadas, mientras que un motor de reglas comprueba las compatibilidades y determina si la configuración es viable. Finalmente, el modelo puede utilizar el resultado para redactar una explicación comprensible, pero sin modificar la decisión obtenida. La orquestación controla el proceso y permite detenerlo cuando falta información o aparecen contradicciones, además de registrar los datos y las reglas utilizados para poder reconstruir lo sucedido.
Esta separación no elimina todos los riesgos, porque una interpretación incorrecta en la primera etapa puede condicionar las siguientes, pero permite introducir comprobaciones y evitar que cada decisión dependa exclusivamente de la respuesta generada por el modelo.
El determinismo como propiedad del sistema
Aquí es donde creo que merece la pena cambiar ligeramente la perspectiva. En lugar de intentar que cada componente sea determinista, podemos trabajar para que el comportamiento final del sistema resulte suficientemente predecible, entendiendo además que esa consistencia debe poder medirse y no quedarse simplemente en una expectativa.
Podemos ejecutar repetidamente una misma consulta bajo condiciones controladas y comprobar si obtenemos respuestas idénticas, si llegamos a las mismas decisiones y si esas decisiones son correctas. Son cuestiones diferentes, porque un sistema puede generar explicaciones distintas y mantener resultados operativos consistentes, del mismo modo que puede repetir una respuesta equivocada en todas las ejecuciones. También necesitamos trazabilidad para investigar las discrepancias, conservando no solo el prompt y la respuesta, sino las versiones del modelo, la información recuperada y las reglas aplicadas.
No todos los procesos necesitan las mismas garantías. Podemos aceptar distintas redacciones en una propuesta comercial, pero difícilmente deberíamos admitir variaciones arbitrarias en precios, compatibilidades o aprobaciones. Por eso considero que, cuando diseñamos soluciones de IA, merece la pena dedicar tanto esfuerzo a controlar el contexto, definir la arquitectura y medir la consistencia como a seleccionar el modelo que vamos a utilizar.
No vamos a eliminar completamente la naturaleza probabilística de los LLM, pero sí podemos diseñar sistemas que reduzcan su impacto sobre las decisiones de negocio. Y probablemente esa sea una de las diferencias más importantes entre conseguir que una automatización funcione y conseguir que podamos confiar en ella cuando pasa a formar parte de nuestros procesos habituales.